

Jev: модель, которая ничего не пишет
Если вы много слышали про Jev, но так и не разобрались до конца в чем состоит его идея, то мы с командой решили собрать все воедино и рассказать что это за загадочно дешевая модель, которая выдает бесплатно токены ответа.
Начнем
Мы привыкли, что нейросеть должна что-то генерировать. ChatGPT пишет ответ, Claude Code - пишет код, Gemini может редактировать таблицы и презентации. Даже если от модели требуется всего лишь определить, спам перед ней или нет, внутри все равно запускается большая языковая модель, которая последовательно генерирует токены, а взаимодействие с ней происходит в формате чата.
Но в сентябре все изменилось и появилась новая модель, которую можно смело назвать первой попыткой изменить работу с LLM. Встречайте - Jev.
Что такое Jev?
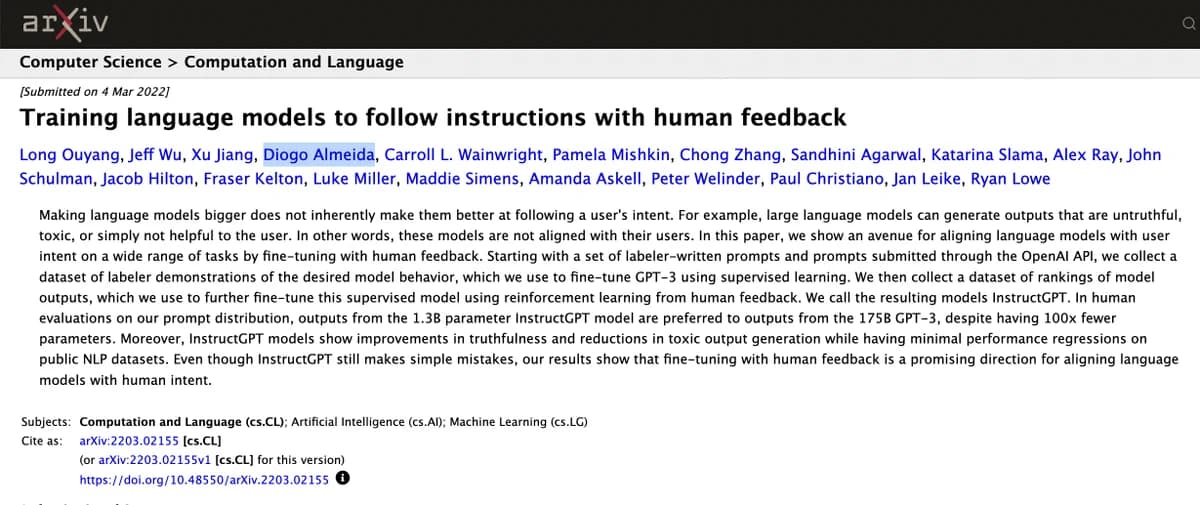
Это новая модель от TypeSafe AI, созданная не для общения с человеком, а для принятия решений внутри программ. За TypeSafe стоит Диого Алмейда, бывший исследователь OpenAI.
Его имя есть среди авторов работы про InstructGPT – одной из ключевых работ по обучению языковых моделей следовать инструкциям человека, а позднее и в техническом отчете GPT-4.
И здесь у Jev довольно интересная предыстория.
По словам Алмейда, после появления сильных чат-моделей его занимал вопрос: если AI уже настолько хорошо понимает язык, где обещанная тотальная автоматизация?
Модели научились великолепно разговаривать с людьми, но внутри обычного программного обеспечения они все еще выглядят немного чужеродно. Программы работают с функциями, boolean-значениями, enum'ами и конкретными состояниями. LLM отвечает строкой текста.
В интервью TechCrunch Диого Алмейда сформулировал проблему примерно так: “последние годы индустрия очень хорошо оптимизировала AI под человеческий язык, хотя компьютеры «говорят» на другом языке. Два года назад он ушел из OpenAI и основал TypeSafe AI, чтобы попробовать построить модели именно для этого слоя автоматизации”.
15 сентября компания вышла из stealth (прим. Стелс режим означает создавать стартап без огласки) и показала свою первую модель – Jev.
Название тоже не случайное. Оно отсылает к экономисту Уильяму Стэнли Джевонсу и парадоксу Джевонса: когда использование ресурса становится эффективнее и дешевле, общий спрос на него может не уменьшиться, а, наоборот, вырасти.
Логика TypeSafe похожая: если сделать машинный интеллект на порядки дешевле, разработчики начнут использовать его в местах, где сегодня вызов LLM просто не имеет экономического смысла.
Так как работает Jev?
Очень просто. На вход модели можно передать контекст, а на выходе получить заранее определенное значение и вероятность того, насколько модель уверена в своем решении.
Например, вместо вопроса к LLM:
«Проанализируй это сообщение и определи, нужно ли передавать его оператору».
Jev можно дать само сообщение и два возможных состояния:
escalate = true / false
В ответ приложение сразу получит решение и вероятность — например, true, 0.97.
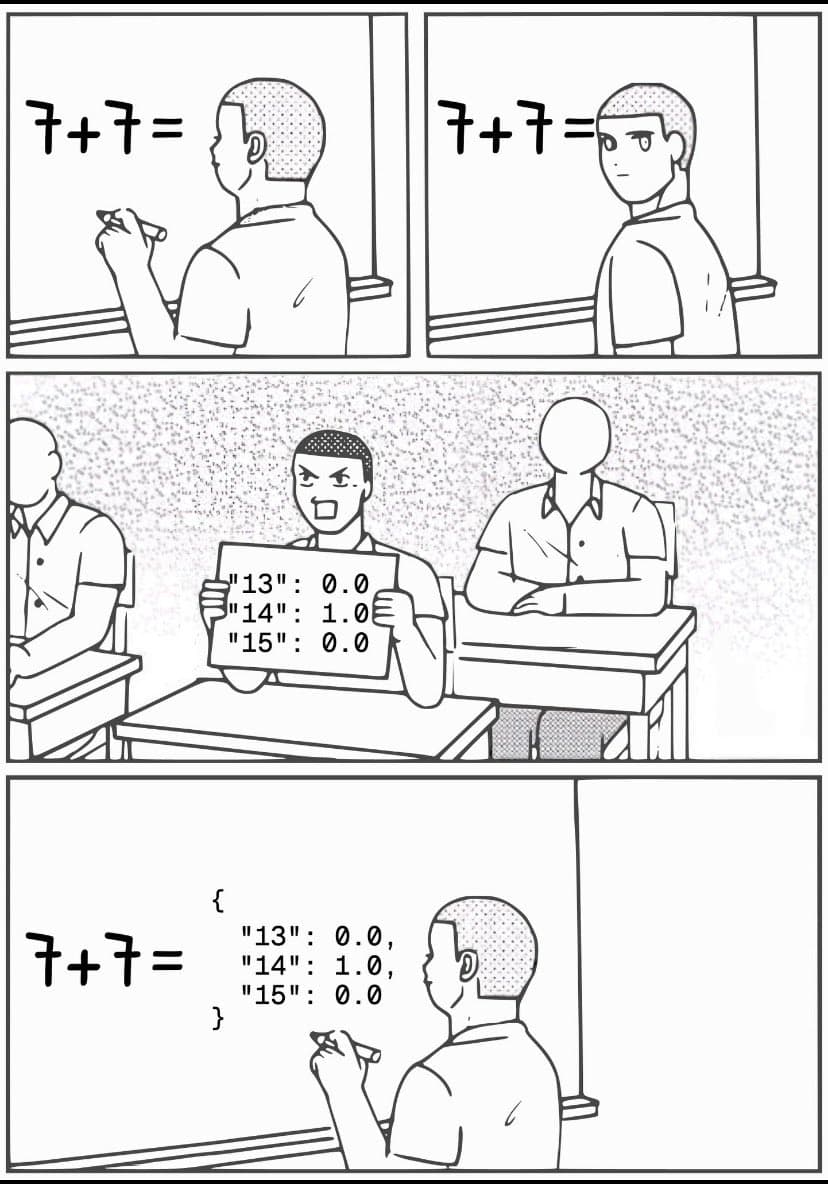
Никакого текста вокруг. Никакого JSON, который сначала нужно попросить правильно сгенерировать, а потом распарсить. Только значение, которое сразу может использовать код.
TypeSafe описывает Jev довольно удачной фразой: на входе может быть обычный неструктурированный контекст, а на выходе типизированное решение с вероятностью. Именно поэтому сравнивать Jev с GPT или Claude напрямую не совсем правильно.
Jev не пытается быть еще одной LLM
Давайте представим ИИ-агента, которому нужно выполнить задачу пользователя. В какой-то момент ему необходимо решить, что делать дальше: вызвать поиск, открыть базу данных, передать задачу другому агенту или закончить работу.
Сегодня это решение часто принимает та же LLM, которая выполняет основную задачу. Мы отправляем ей историю диалога, описание доступных инструментов и спрашиваем: «Что делать дальше?»
Модель анализирует контекст и начинает генерировать ответ токен за токеном.
Но приложению на самом деле не нужен этот ответ. Ему нужно одно значение:
search_web
И здесь проявляется идея Jev.
Обычные LLM оптимизированы под генерацию последовательностей текста. Jev – под выбор между заранее определенными решениями. Причем несколько вопросов модель может оценивать параллельно, а не генерировать один ответ за другим. TypeSafe называет такие модели System One Models, отсылая к «быстрой» системе мышления из Thinking, Fast and Slow Даниэля Канемана.
Условно:
LLM: «Подумай, что нужно сделать, и расскажи мне».
Jev: «Вот варианты. Выбери».
Из-за этого область применения получается намного уже, чем у GPT или Claude. Jev не напишет письмо, не создаст интерфейс и не объяснит квантовую механику. Но там, где нужен именно выбор, это ограничение превращается в преимущество.
Зачем вообще тогда делать отдельную модель?
Ответ простой - потому что сейчас LLM используются для огромного количества задач, для которых генерация языка избыточна.
Давайте представим антифрод-систему, через которую проходит миллион операций. Для каждой нужно решить: выглядит транзакция подозрительной или нет.
Можно отправить миллион запросов в большую LLM.
Она прочитает описание каждой операции, сгенерирует что-то вроде:
{"fraud": false}
После чего приложение распарсит JSON и наконец получит тот самый false, который ему был нужен с самого начала.
Работать будет. Но вопрос – зачем здесь вообще была генерация текста?
TypeSafe утверждает, что отказ от нее позволяет Jev работать значительно быстрее и дешевле. Компания заявляет latency примерно от 70 до 500 мс и цену $0,042 за миллион входных токенов. В собственных workflow-тестах TypeSafe сообщала о разнице вплоть до примерно 194× по скорости и 445× по стоимости относительно LLM. Это результаты самой компании и распространять их на любые ИИ-задачи, конечно, нельзя. Но сама идея важнее конкретных бенчмарков.
Не весь интеллект в приложении должен быть генеративным. Иногда программе просто нужен очень дешевый способ принять достаточно хорошее решение.
Почему вокруг Jev столько шума
Jev удачно попал в момент, когда разработчики начали упираться не только в качество моделей, но и в стоимость агентных систем.
Один запрос пользователя уже давно не означает один вызов модели. Агент может сделать десятки промежуточных шагов: классифицировать задачу, выбрать инструмент, проверить результат, решить, нужно ли продолжать, выбрать следующую модель, оценить риск действия.
Если каждый такой шаг выполнять через frontier LLM, стоимость и latency быстро складываются.
Jev предлагает оставить большие модели там, где действительно требуется генерация или сложное reasoning, а мелкие решения отдать специализированной модели.
И интерес оказался не только теоретическим.
После появления Jev в Vercel AI Gateway модель за первые 24 часа использовали почти 13% платных команд платформы. По данным Vercel, это более чем вдвое превысило предыдущий рекорд запуска модели в Gateway. Jev стала самой быстро распространявшейся новой моделью за всю историю сервиса.
Это еще не доказывает, что через полгода все будут строить приложения на System One Models. Но для совершенно нового класса моделей старт получился необычно заметным.
А что с «нулевыми галлюцинациями»?
Это одна из самых громких формулировок в анонсе TypeSafe.
Компания пишет, что Jev «не может галлюцинировать». Но здесь важно понимать, что именно имеется в виду.
Если вы заранее определили:
priority = low | medium | high
Jev не вернёт:
priority = banana
В этом смысле модель действительно не может уйти от заданного формата. Возможные outputs определяются заранее, и программа всегда получает значение нужного типа.
Но Jev все еще может принять неправильное решение и поставить low, когда правильным ответом было high.Поэтому интереснее другая особенность модели – probabilities.
Вместе с ответом Jev показывает свою уверенность, что позволяет строить систему, в которой решения с высокой уверенностью выполняются автоматически, а пограничные случаи отправляются более мощной модели или человеку. То есть проблема не исчезает магически, а она просто становится гораздо удобнее управляемой из кода.
Но как и все LLM-модели, Jev тоже не идеален. Авторы Jev открыто говорят об ограничениях модели. Она слабее крупных reasoning-моделей в задачах, где требуется глубокое пошаговое рассуждение, например, в математике или шахматах.
У Jev также нет глубоких знаний во всех узких предметных областях. Но модели можно передать необходимый контекст, чтобы она учитывала его при принятии решения. Для специфических сценариев использования разработчики также предлагают отдельное обучение модели. Еще одно важное отличие, ему нужно заранее задать структуру ответа примерно как если бы вы составляли вопрос с несколькими вариантами ответа.
Что можно делать с Jev
Понять Jev проще всего не по описанию модели, а по тому, что разработчики начали собирать с ней почти сразу после релиза.
Один из самых наглядных примеров – браузерный агент от Browser Use. Вместо того чтобы каждый раз обращаться к большой модели и ждать, пока она рассуждает над следующим действием, Jev быстро смотрит на доступные элементы страницы и решает, что сделать дальше: нажать кнопку, выбрать пункт, прокрутить страницу или перейти к следующему шагу. В одном из демо такой агент нашел рейс из Цюриха в Лондон примерно за семь секунд.
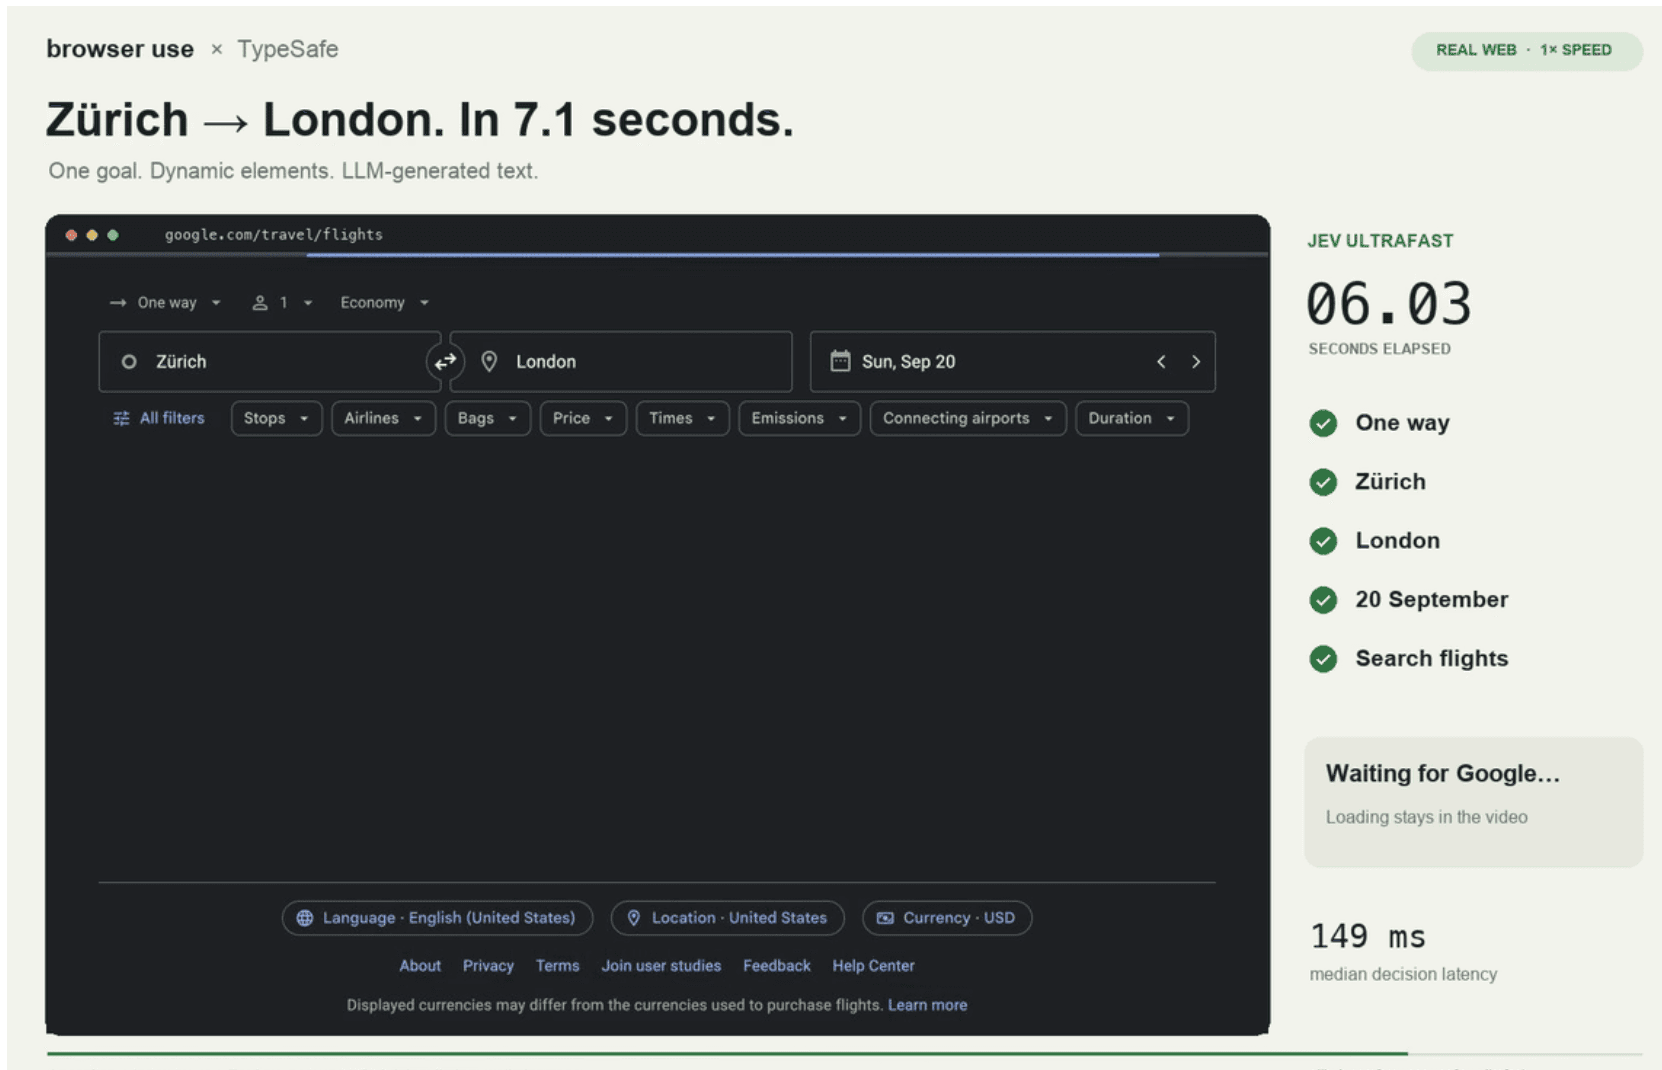
Большая LLM при этом подключается только в тех местах, где действительно нужно сгенерировать текст. Ссылку на гит, прилагаем: https://github.com/browser-use/jev-ultrafast
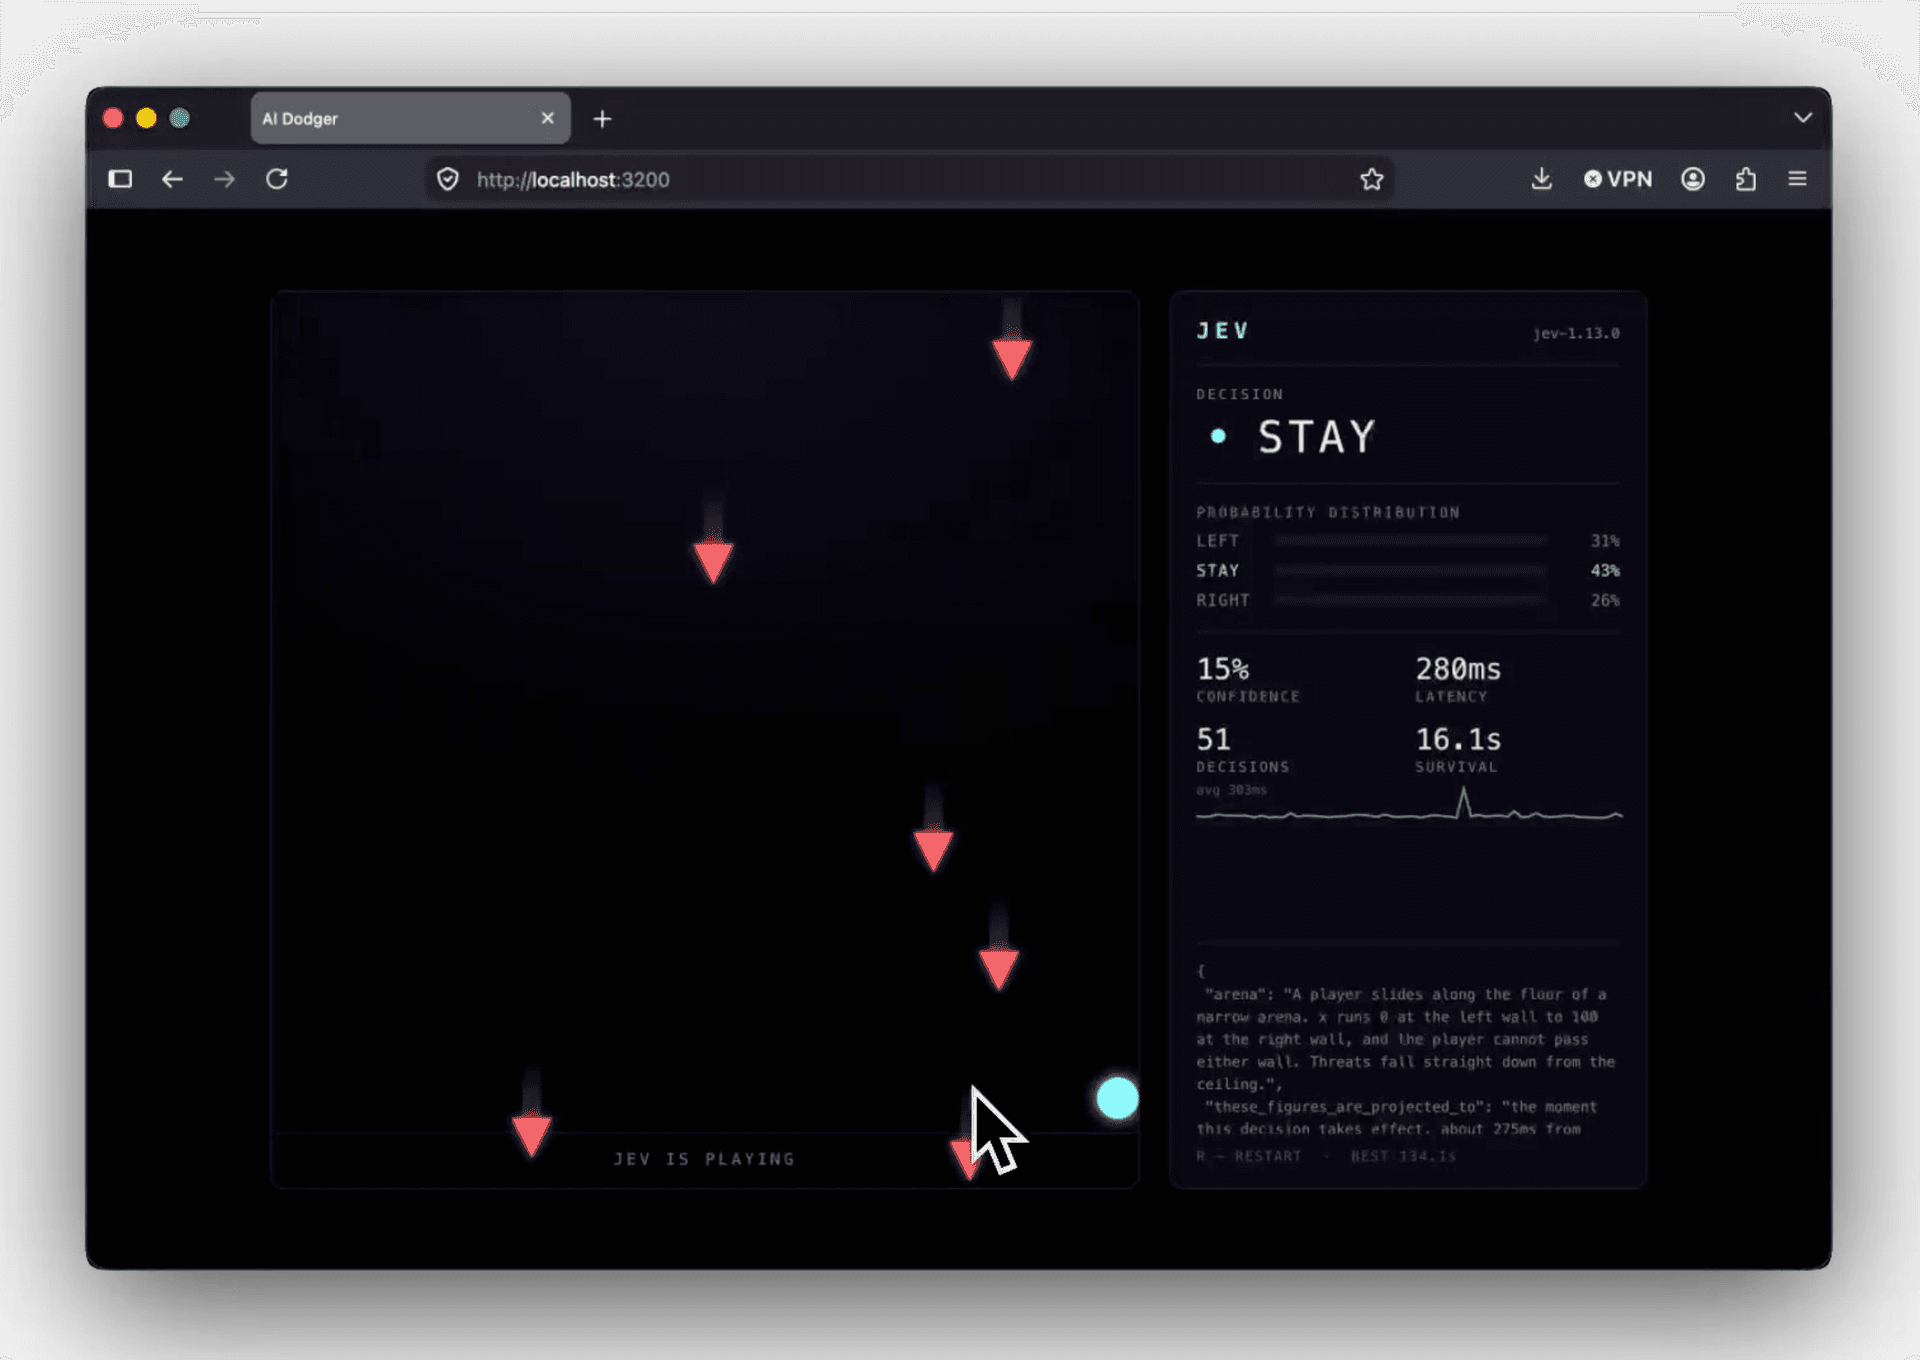
Также скорость Jev позволяет использовать его и в более динамичных сценариях. Например, один из разработчиков сделал простую игру, где модель в реальном времени управляет персонажем и постоянно решает, куда двигаться, чтобы обходить препятствия.
В другом эксперименте Jev превратили в торгового агента, который самостоятельно принимает решения о сделках на виртуальном счете в $10 000.
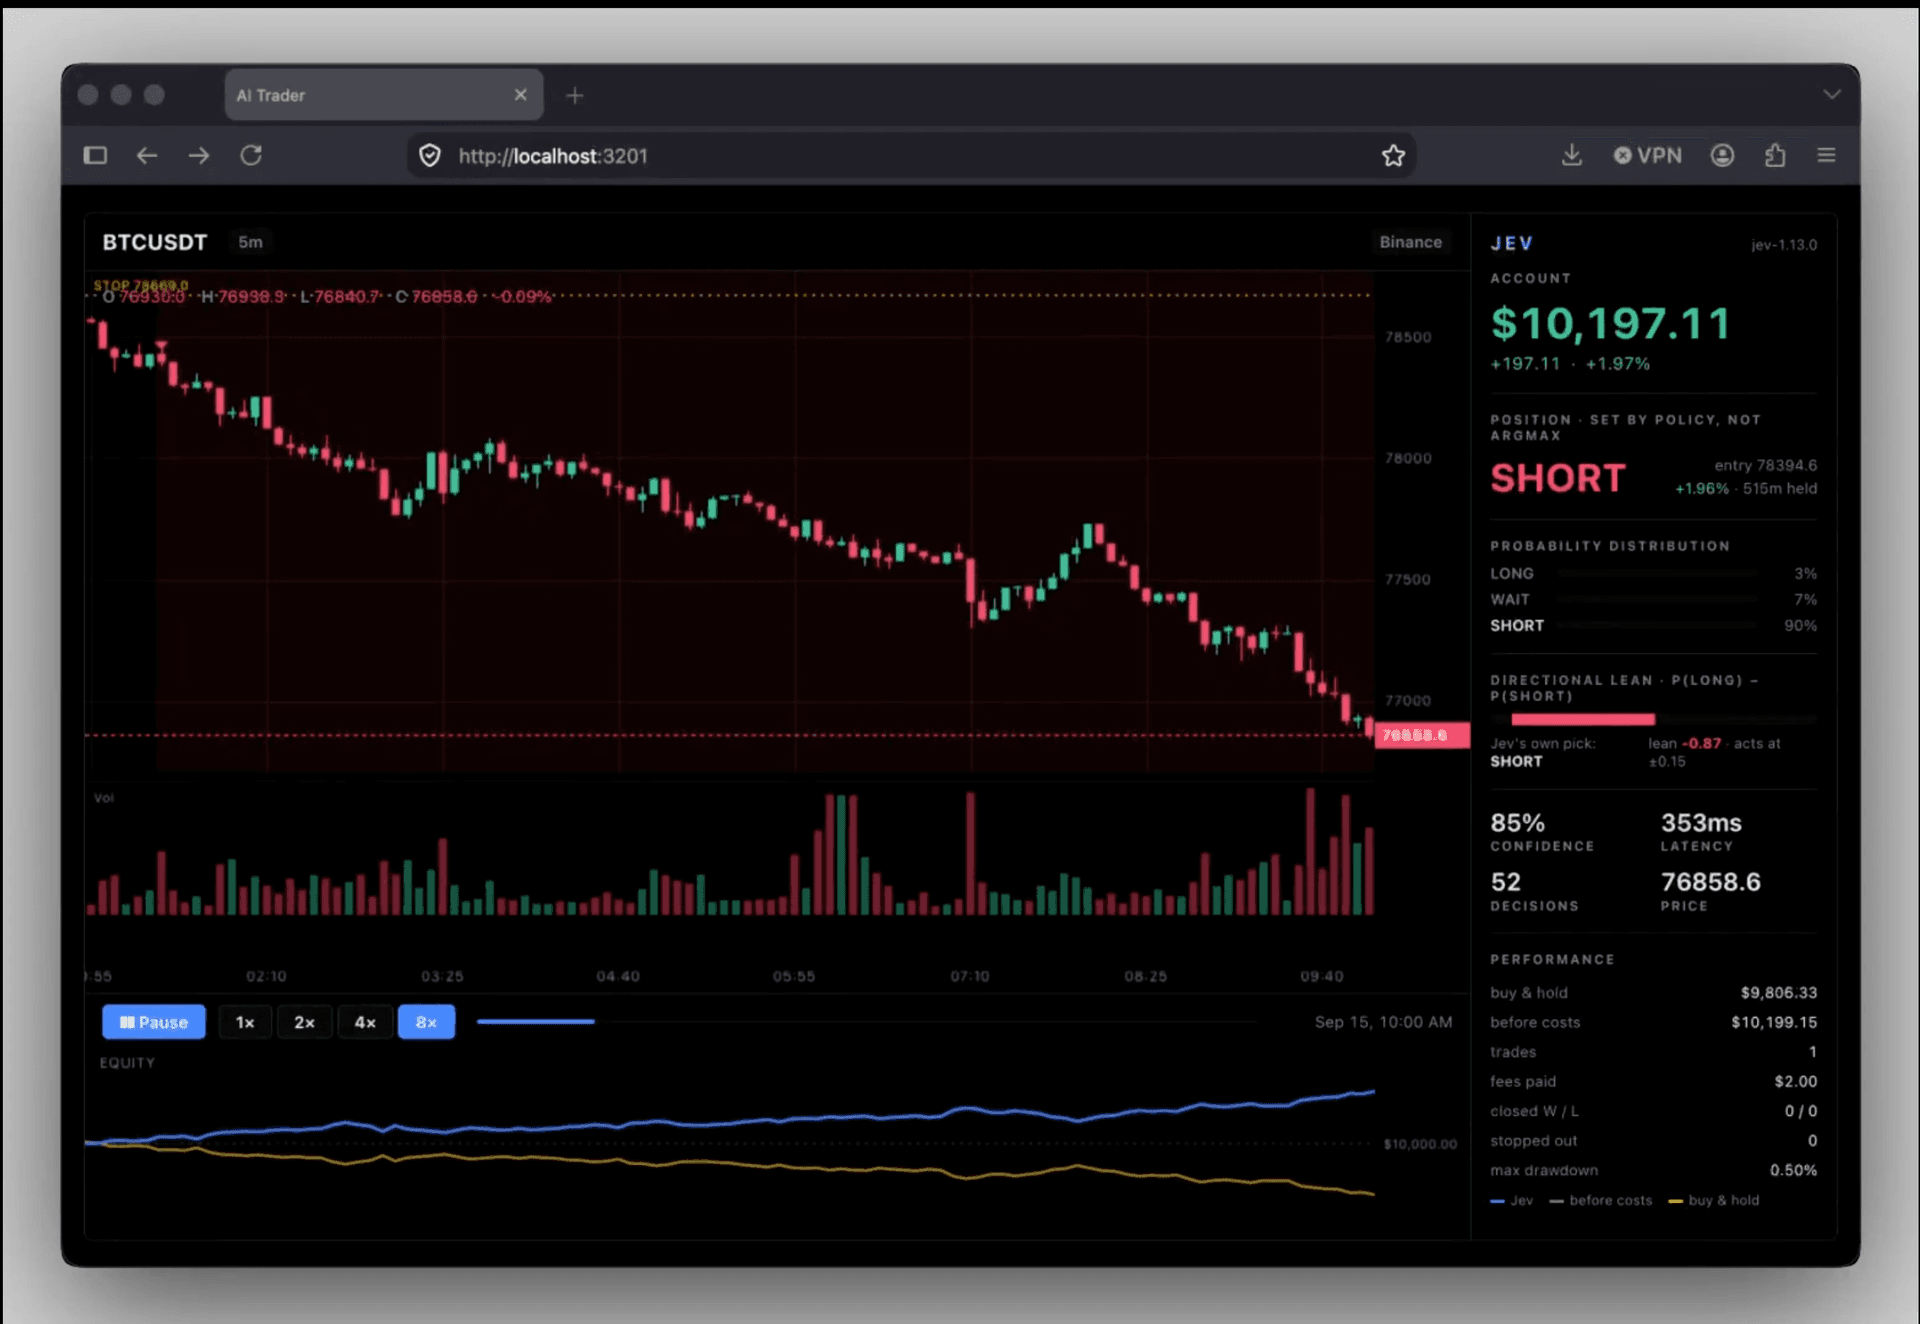
Не как готовую инвестиционную стратегию, конечно, а как демонстрацию того, что модель может выступать быстрым «мозгом» внутри системы, где решения нужно принимать одно за другим.
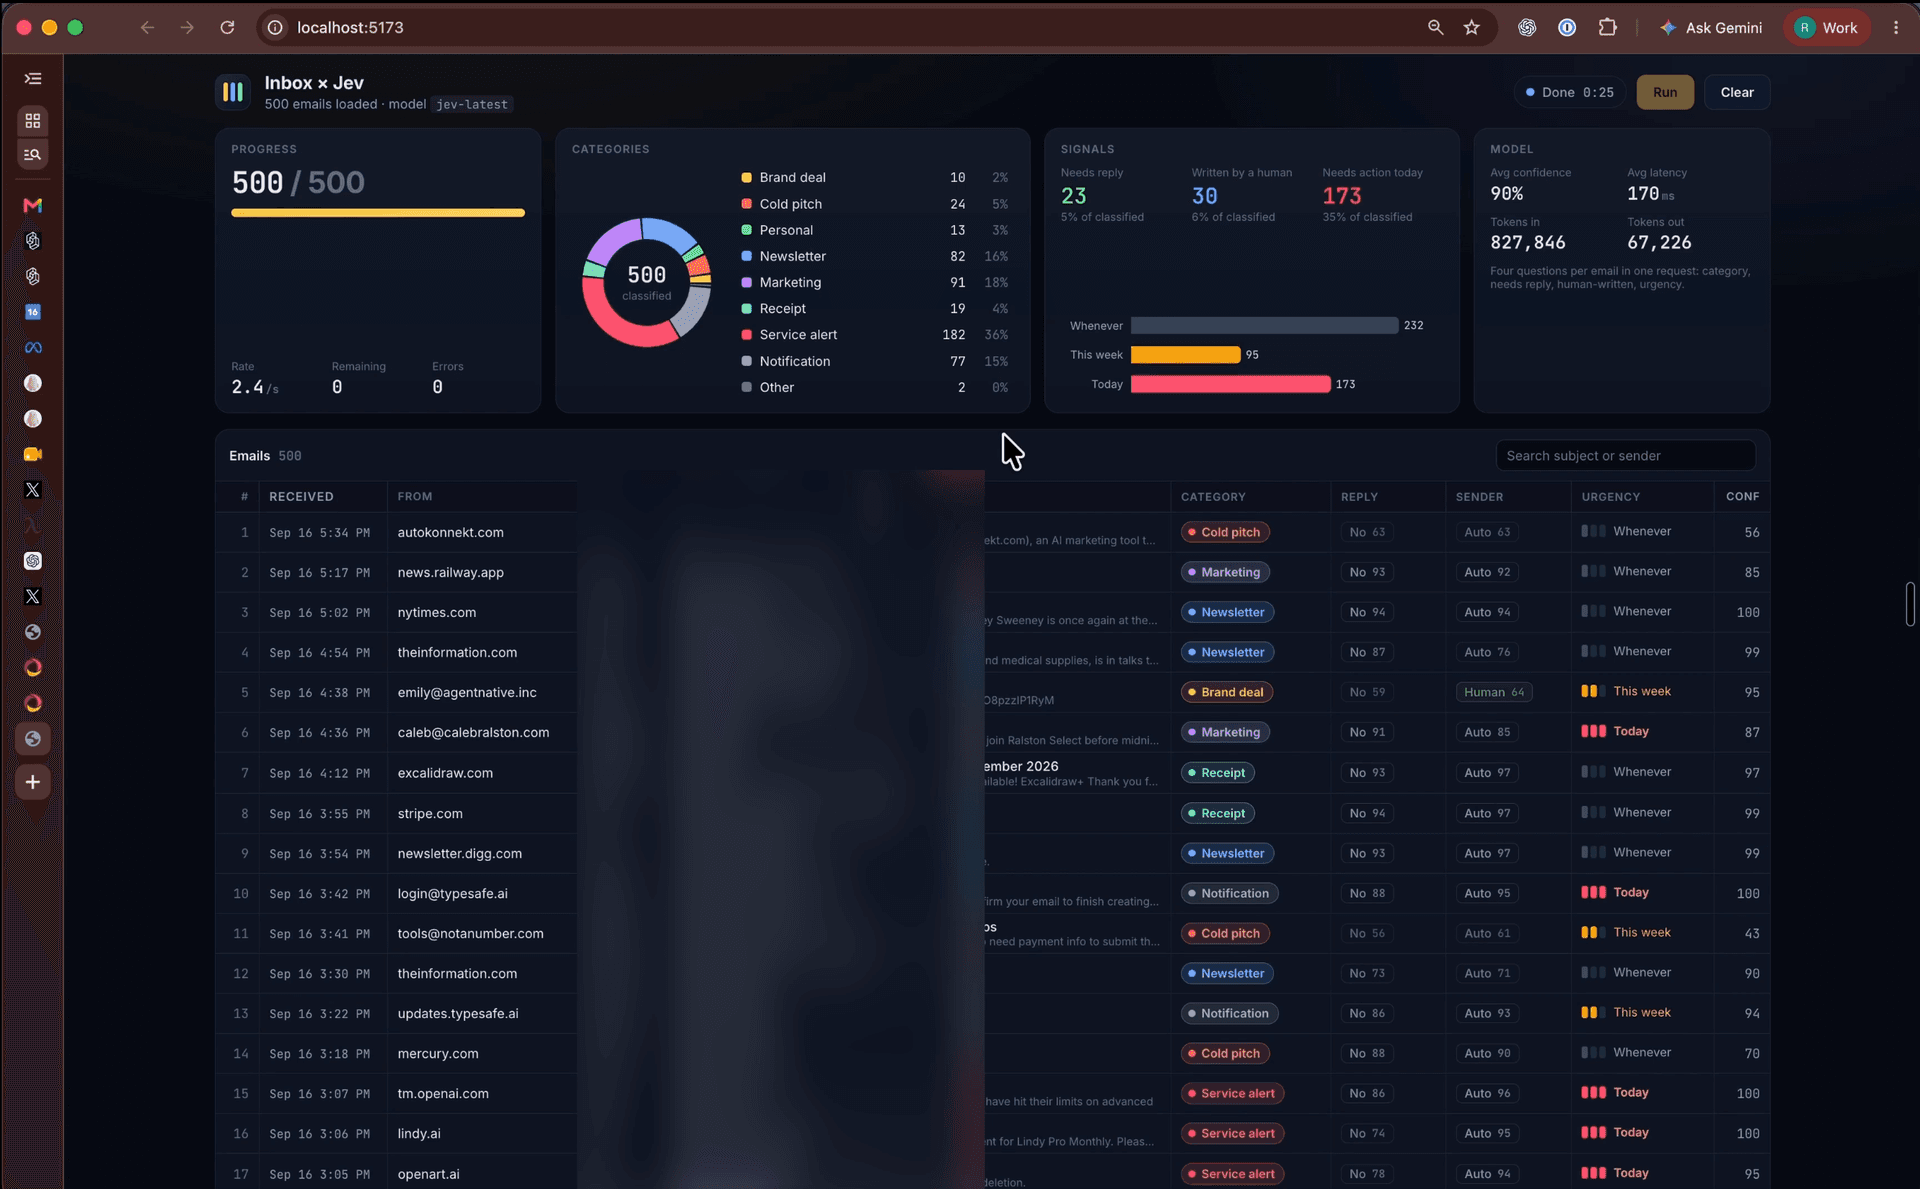
Но, пожалуй, еще интереснее Jev выглядит в более повседневных задачах. Один из энтузиастов прогнал через модель 500 писем и за несколько секунд распределил их по категориям всего за несколько центов.
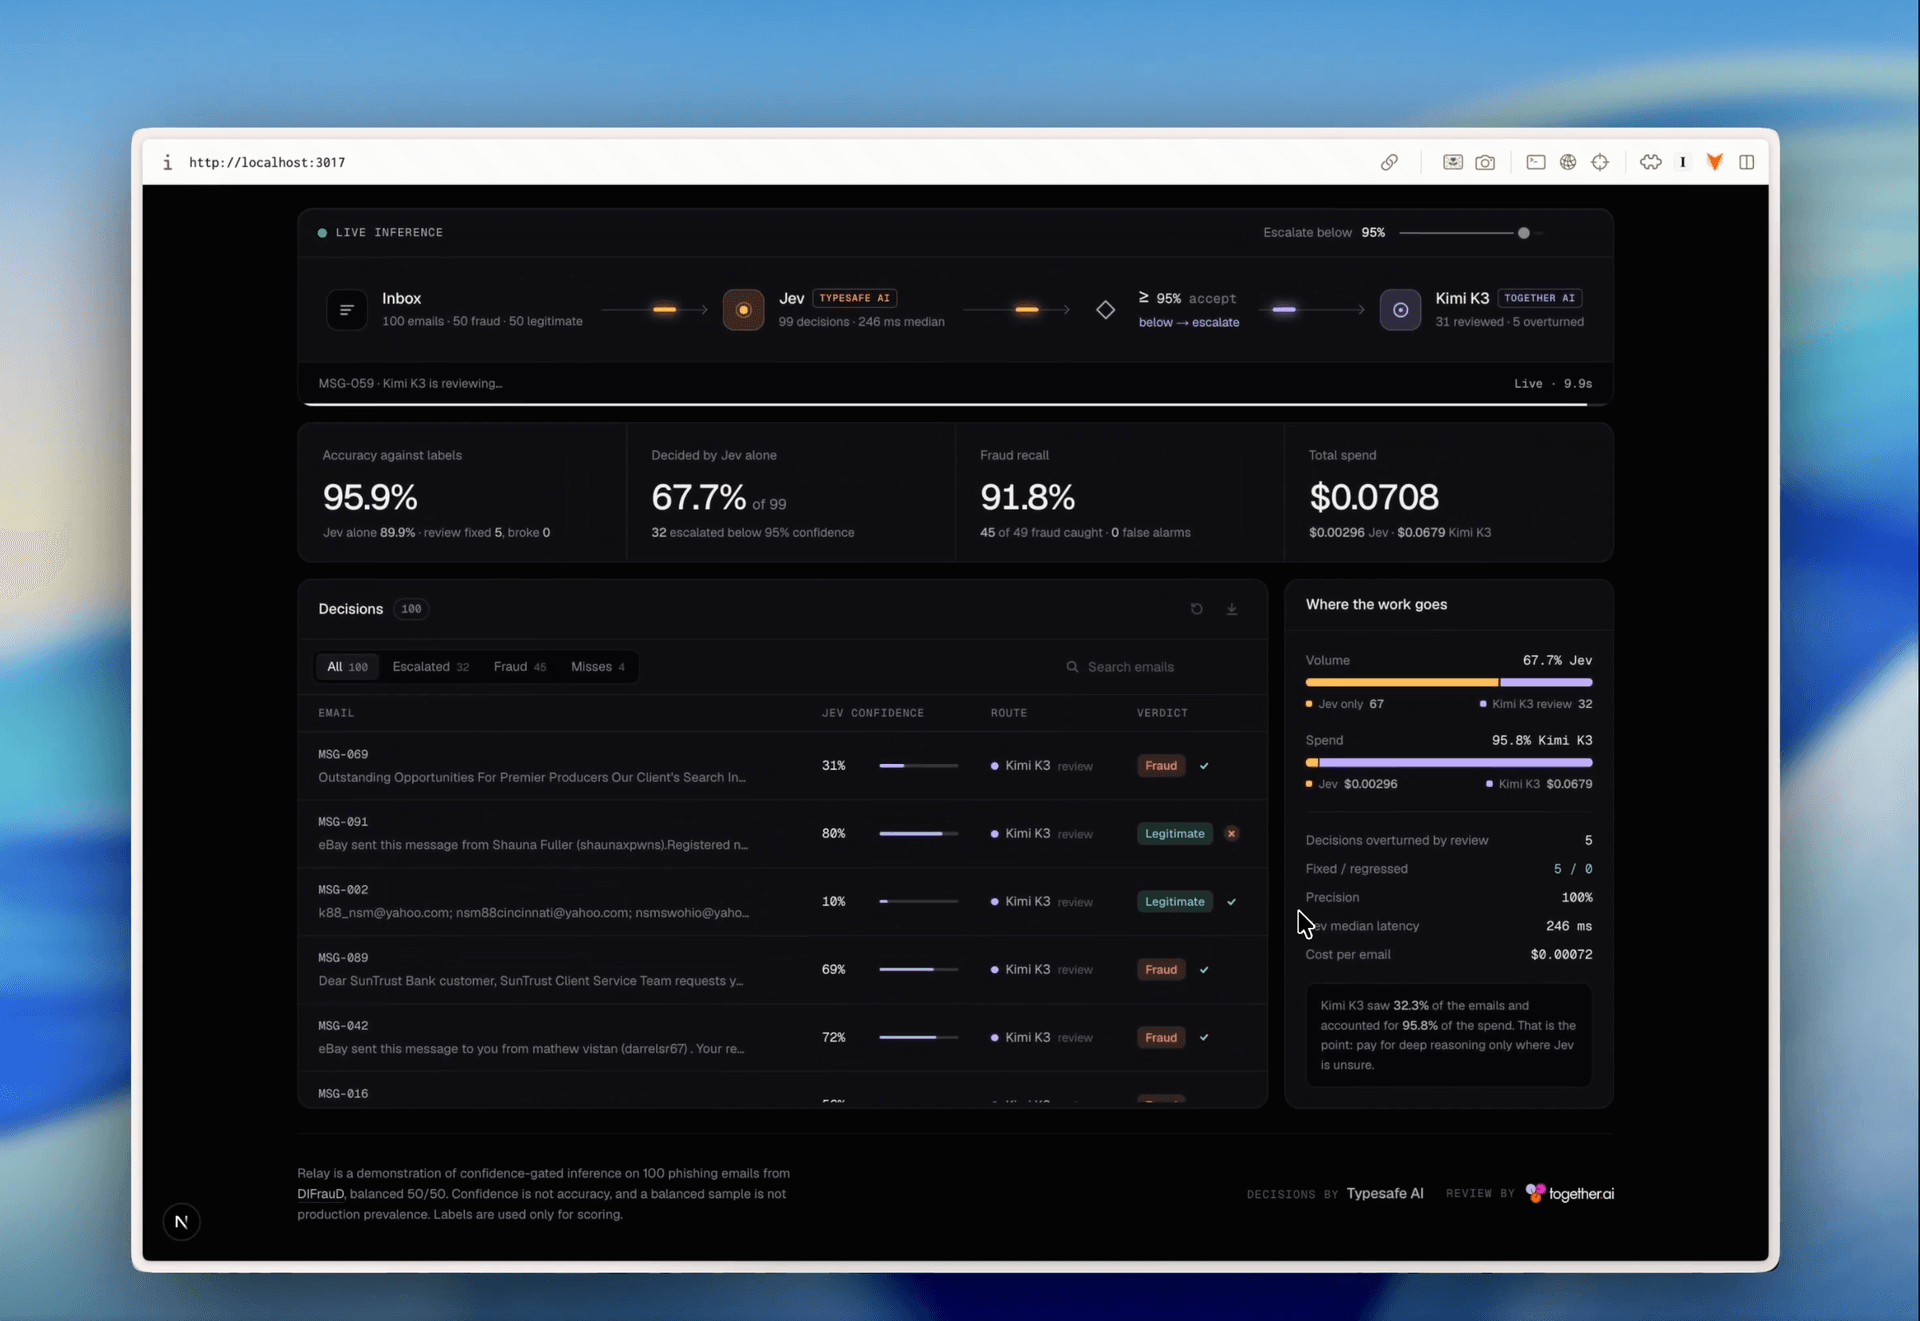
А другой собрал на похожей идее антифрод-систему, где Jev быстро проверял входящие письма, а все, в чем модель была недостаточно уверена, отправлялось на дополнительную проверку более крупной LLM.
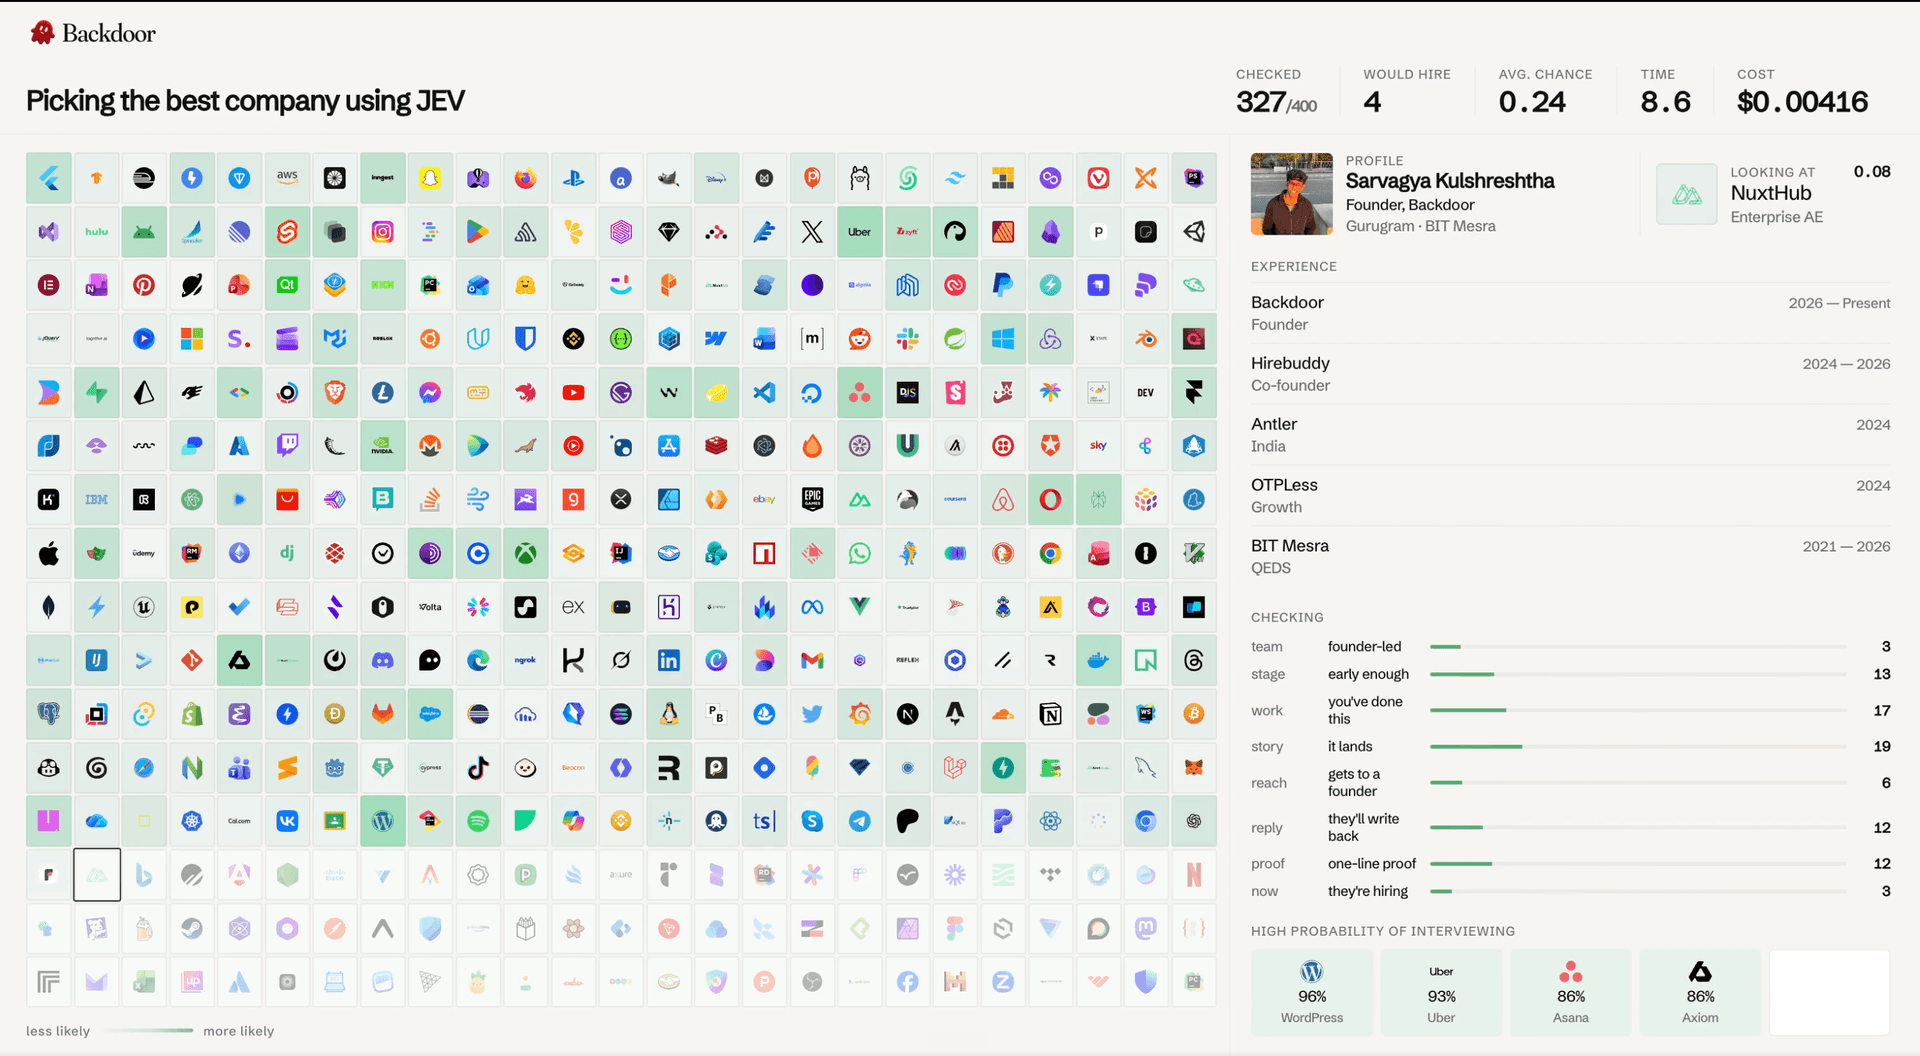
Тот же принцип можно применять и к поиску подходящих вариантов. Другой из пользователей передал Jev профиль кандидата и данные о 400 компаниях. Модель за несколько секунд оценила, какие позиции подходят человеку лучше всего, выставила уровень уверенности и указала, где требования вакансии не совпадают с опытом кандидата.
Как вы теперь видите, Jev - не еще один чат-бот и не модель, которую стоит просить написать статью или объяснить квантовую физику. Ее сильная сторона в скорости выбора из заранее понятных вариантов.
Поэтому Jev можно представить как небольшой “decision layer” внутри продукта. Перед системой лежат сотни писем – Jev решает, к какой категории относится каждое. Агент видит десять возможных действий – Jev выбирает следующее. Есть сотни кандидатов или товаров – модель определяет наиболее подходящие. При этом более дорогую и медленную LLM можно подключать только тогда, когда задача действительно требует глубокого рассуждения или генерации текста.
И, возможно, именно такая связка выглядит одним из самых интересных сценариев.
Большие LLM никуда не уходят
Самая интересная идея Jev вообще не в том, чтобы заменить GPT, Claude или Gemini. Скорее он показывает возможную архитектуру следующего поколения искусственного интеллекта.
Сегодня мы часто пытаемся построить все вокруг одной большой модели. Она понимает пользователя, рассуждает, выбирает инструменты, проверяет себя, принимает решения и генерирует финальный результат. Вместо этого разные типы интеллекта можно разделить.
Большая LLM занимается сложным reasoning и генерацией. Jev принимает быстрые промежуточные решения. Обычный код выполняет то, что должно выполняться детерминированно.
Конечно, пока рано говорить, станет ли Jev началом нового большого класса моделей. System One Models – термин самой TypeSafe, модель только появилась, а значительная часть ее технических преимуществ пока подтверждается внутренними тестами компании. Но вопрос, который она поднимает, кажется гораздо важнее конкретного продукта.
За последние годы ИИ-индустрия научилась делать модели, способные потратить тысячи токенов на сложное рассуждение. Следующая задача может оказаться противоположной: научиться тратить интеллект только там, где он действительно нужен. И если для решения достаточно одного true, возможно, генерировать ради него целый ответ действительно больше не обязательно.